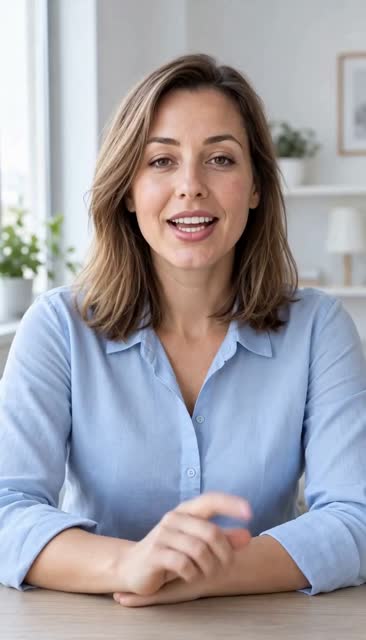
Оживить фото
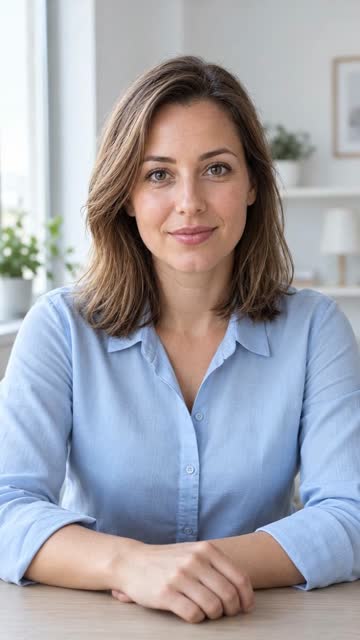
Превратите портрет в короткое видео с живой мимикой и голосом. Русская реплика запрошена; точность речи не проверена.
2 800 токенов8 сек · 768P · звук запрошен

Новое поколение MiniMax: три режима генерации — по тексту и изображению, по первому и последнему кадру и по референсам (фото, видео, аудио), качество до 4K и до 15 секунд.
Превратите портрет в короткое видео с живой мимикой и голосом. Русская реплика запрошена; точность речи не проверена.
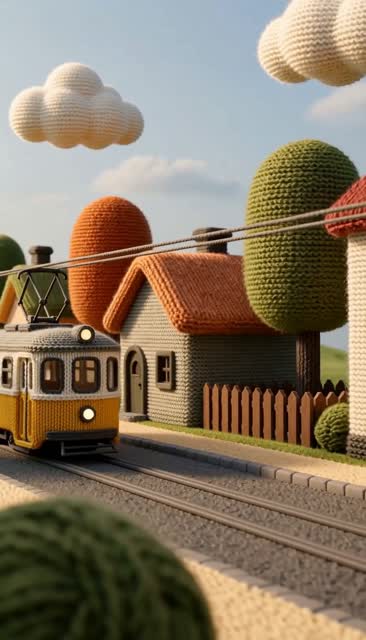
Создайте необычный ролик для соцсетей — например, город из пряжи
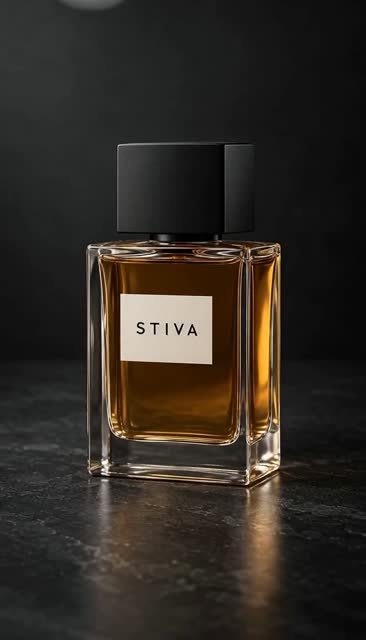
Создайте рекламный ролик из изображения своего товара
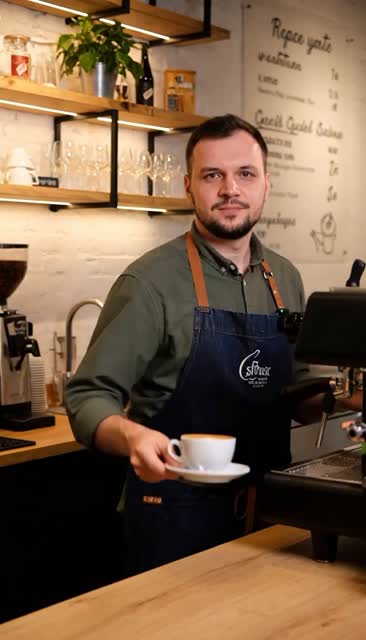
Создайте короткую сцену с естественной речью на русском языке. Русская реплика запрошена; точность речи не проверена.
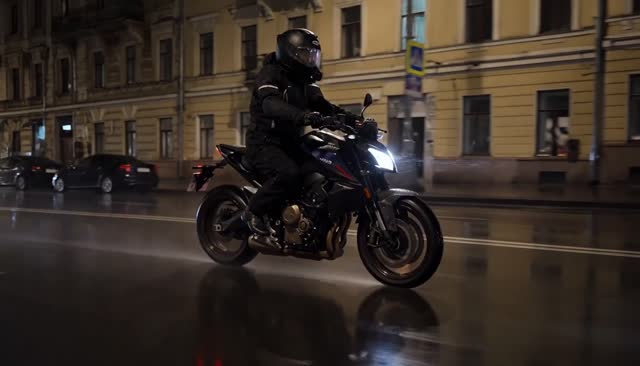
Создайте атмосферный кадр для клипа, тизера или короткометражки
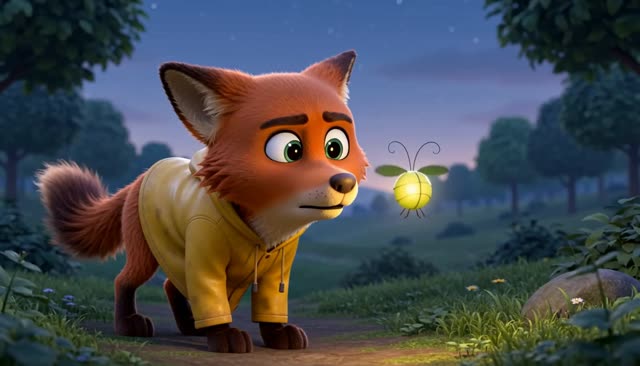
Оживите придуманного героя и добавьте ему голос. Русская реплика запрошена; точность речи не проверена.
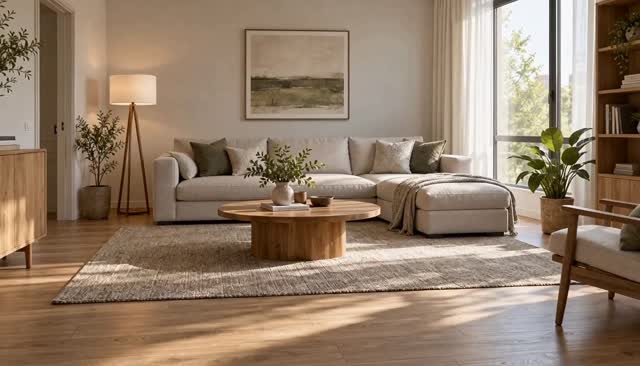
Превратите изображение интерьера в плавную видеопрезентацию
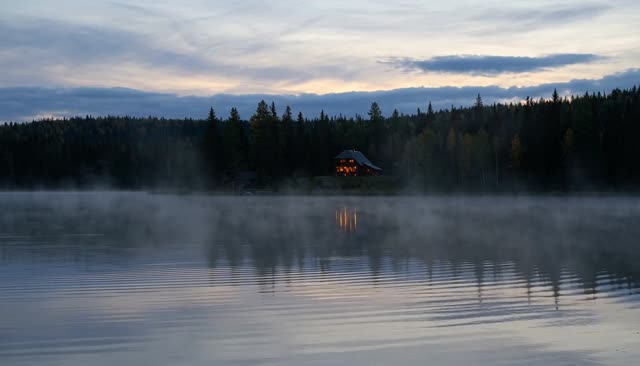
Создайте живой фон для сайта, публикации или музыкального проекта
Оживи исходную фотографию. Женщина смотрит в камеру, естественно улыбается и говорит по-русски: “Привет! Сегодня отличный день для новых идей”. Затем слегка поворачивает голову вправо и возвращает взгляд в камеру. Сохрани внешность, причёску, одежду и фон исходного изображения. Естественная мимика и точная синхронизация губ с русской речью. Голос спокойный, дружелюбный, слова произносятся отчётливо и полностью. Камера неподвижна, освещение постоянно. На фоне тихая атмосфера комнаты. Один непрерывный кадр. Без музыки, субтитров и надписей
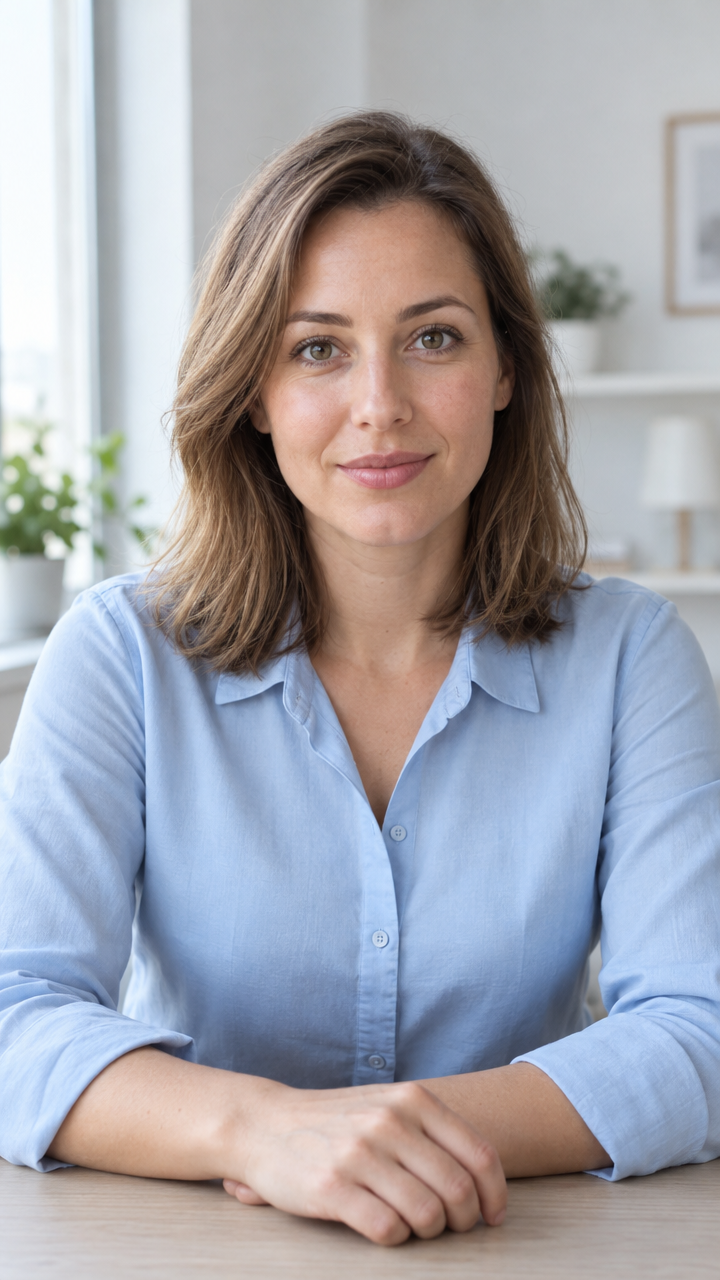
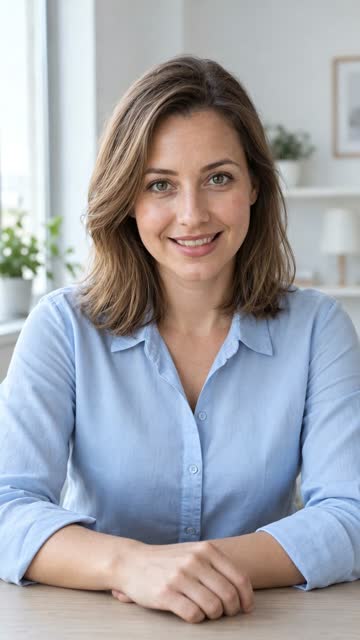
Minimax H3 — омни-модальная генеративная модель компании MiniMax из Шанхая для создания видео длительностью 4–15 секунд. Она объединяет текст, изображения, видео и аудио в едином контексте, поддерживает генерацию по первому и последнему кадру или референсам, нативное разрешение 2K, вывод до 4K и синхронный стереозвук.
Для Minimax H3 полезен режиссёрский промпт: последовательно опишите сцену, объект, действие, камеру, свет, стиль и звук. При работе с референсами явно укажите роль каждого файла и желаемую связь между начальным и финальным кадрами.
Сними 10-секундный рекламный ролик часов на чёрном камне: медленный облёт камеры, холодный контровой свет, капли воды, премиальная предметная съёмка. Звук: тихий механизм и глубокий атмосферный бас.Используй первое изображение как начальный кадр, второе — как финальный. За 8 секунд камера плавно приближается к витрине, дневное освещение сменяется вечерним, вывеска мягко загорается.Возьми движение камеры и темп из референсного видео, внешний вид героя — из фотографии. Создай 12-секундную сцену прогулки по футуристическому рынку, сохрани лицо, одежду и естественную пластику.| Стоимость | 350 токенов / запрос |
|---|---|
| Контекстное окно | Промпт до 7 000 символов; смешанный контекст — до 12 файлов, включая до 9 изображений и до 3 видео |
| Дата выпуска | Июль 2026 года |
| Разработчик | MiniMax, Шанхай, Китай |
| Тип модели | Омни-модальная генеративная модель; Dense single-stream Transformer, около 33 млрд параметров |
| Работа с файлами | Текст, JPG, PNG, WEBP, HEIC, HEIF, видео H.264/H.265 и аудио WAV/MP3; аудиореференсы принимаются вместе с изображением или видео |
| Ключевые преимущества | Создаёт видео и стереозвук в едином процессе, поддерживает перенос движения и работу с мультимодальными референсами. Нативное 2K и In-Context Regeneration помогают сохранять мелкие детали и текст. |
| Работа с русским языком | Хорошо: понимает подробные инструкции на русском, однако сложные надписи внутри кадра лучше задавать коротко и проверять в готовом видео |
| Параметр | Minimax H3 | Seedance 2.0 | Google Gemini Omni Flash |
|---|---|---|---|
| Контекст / разрешение | Промпт до 7 000 символов; смешанный контекст — до 12 файлов, включая до 9 изображений и до 3 видео | Генерация видео по тексту и изображению; лимиты зависят от платформы доступа | Омни-модальная генерация видео; параметры зависят от используемого сервиса и конечной точки API |
| Дата выпуска | Июль 2026 года | 2026 год, точная дата зависит от версии сервиса | 2026 год, точная дата публично не уточнена |
| Разработчик | MiniMax, Шанхай, Китай | ByteDance | |
| Тип модели | Омни-модальная генеративная модель; Dense single-stream Transformer, около 33 млрд параметров | Мультимодальная модель генерации видео | Омни-модальная модель генерации контента |
| Сильные стороны | Создаёт видео и стереозвук в едином процессе, поддерживает перенос движения и работу с мультимодальными референсами. Нативное 2K и In-Context Regeneration помогают сохранять мелкие детали и текст. | По приведённым сравнительным данным превосходит Minimax H3 в задачах image-to-video. | По доступным бенчмаркам опережает Minimax H3 в text-to-video и image-to-video. |
| Слабые стороны | Максимальная длительность ограничена 15 секундами, поэтому длинные сцены приходится создавать фрагментами и монтировать. | Minimax H3 предлагает единый контекст с изображениями, видео и аудио, нативный стереозвук и сильные возможности редактирования. | Minimax H3 занимает более сильную позицию в редактировании видео и поддерживает до 12 смешанных референсных файлов. |
Minimax H3 — омни-модальная генеративная система MiniMax, выпущенная 31 июля 2026 года. В отличие от специализированных поколений Hailuo 01 и Hailuo 02, она объединяет текст, изображения, видео и аудио в едином контексте. Архитектура H3-Omni Transformer содержит около 33 млрд параметров, из которых при инференсе активны примерно 20 млрд.
Модель создаёт видео по тексту и изображению, по заданным первому и последнему кадрам, а также по смешанным референсам. Через API можно передать до девяти изображений, до трёх видеоклипов и до трёх аудиофайлов, причём аудио используется только вместе с изображением или видео. Общий предел составляет 12 файлов, а промпт — до 7000 символов.
Minimax H3 генерирует ролики длительностью от 4 до 15 секунд, причём в API выбираются только целые значения. Нативным разрешением модели является 2K, а в STIVA также предусмотрены режимы 768p и вывода до 4K. Стереозвук создаётся совместно с видеорядом: модель одновременно формирует речь, музыку и звуковые эффекты, а не добавляет их отдельным модулем.
Модель подходит для рекламы, брендинга, карточек товаров, продуктового дизайна, игровых концептов и предварительной визуализации фильмов. Режимы с референсами полезны для переноса движения, создания анимированных постеров, заставок и каталогов. Однако ролики длиннее 15 секунд потребуется собирать из отдельных сцен, контролируя согласованность персонажей и окружения.
На STIVA модель доступна по подписке без отдельной оплаты API MiniMax. Расход внутреннего баланса зависит от разрешения и длительности: генерация в 768p стоит 350 токенов за секунду, в 2K — 500 токенов за секунду, в 4K — 650 токенов за секунду. Например, десятисекундный ролик потребует 3500, 5000 или 6500 токенов соответственно.